Azure Maia 300 refuerza la eficiencia y la escalabilidad de la infraestructura de IA
- Estrategias
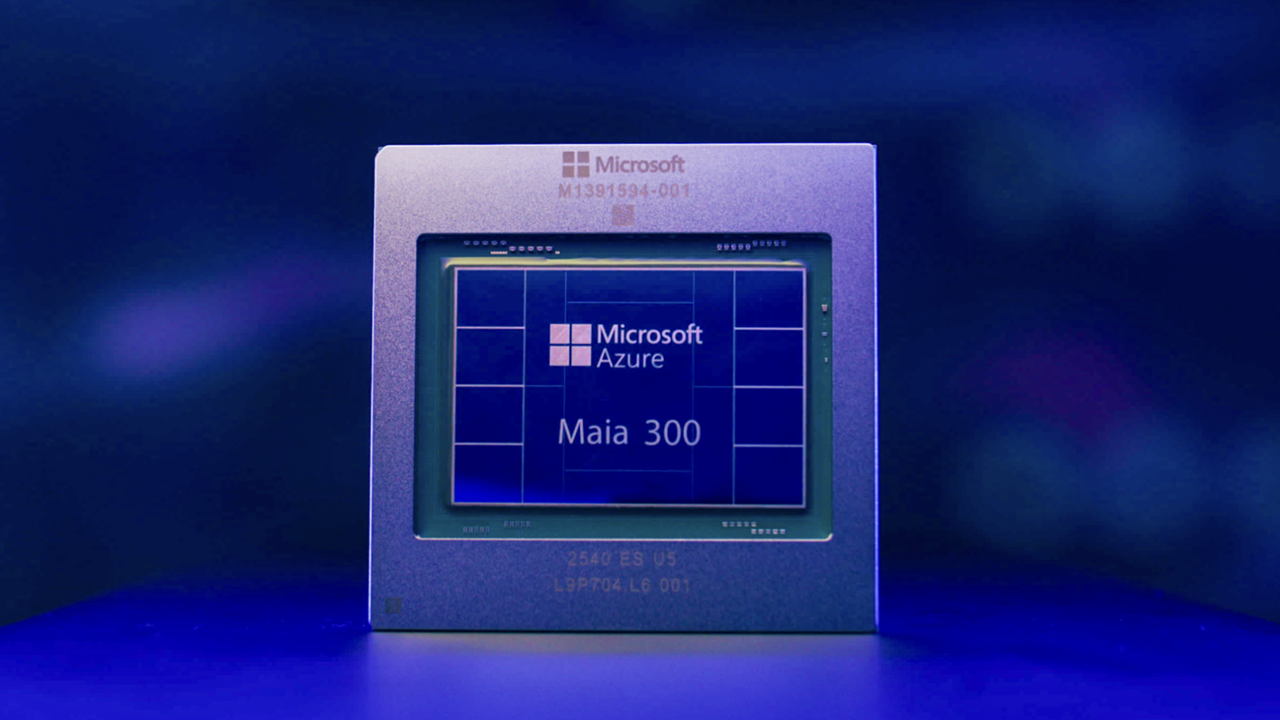
La nueva generación de aceleradores de Microsoft está diseñada para optimizar la inferencia de IA, reducir el consumo energético por unidad de procesamiento y atender cargas de trabajo complejas, desde el razonamiento con contextos extensos hasta los agentes autónomos.
Microsoft amplía su estrategia de infraestructura de inteligencia artificial con Azure Maia 300, una nueva generación de aceleradores concebida para responder a las exigencias de los modelos avanzados y los servicios de IA de gran escala. La arquitectura combina computación, memoria, redes y eficiencia energética en un sistema integrado, con el objetivo de aumentar la capacidad de procesamiento y ofrecer más inferencia por cada megavatio consumido.
El programa Azure Maia constituye una pieza central de la infraestructura de IA de Microsoft. Maia 200 ya ejecuta cargas de trabajo en producción, entre ellas Microsoft Copilot, y proporciona soporte al equipo de MAI para el desarrollo de modelos propios. GitHub Copilot y Microsoft Foundry figuran entre los servicios previstos para incorporar esta tecnología. Los sistemas Maia ejecutan modelos de OpenAI, modelos MAI desarrollados por Microsoft y las principales familias de modelos de código abierto.
La experiencia obtenida con estas cargas de trabajo permite a Microsoft ajustar conjuntamente el hardware y el software a las necesidades reales de sus aplicaciones empresariales y servicios digitales. La compañía prevé desplegar su familia Azure Maia a una escala de varios gigavatios, con Maia como uno de los pilares de su infraestructura de inferencia.
Maia 200 y Maia 300: una arquitectura adaptada a las cargas de trabajo reales
El desarrollo de Azure Maia parte de la colaboración entre los equipos de hardware y software para anticipar las necesidades de memoria, ancho de banda, capacidad de cálculo y conectividad de los modelos. Dado que el diseño de chips exige largos ciclos de ingeniería, la planificación conjunta permite adaptar la arquitectura a las características de las cargas de trabajo y evitar que un único componente limite el rendimiento del sistema.
Maia 200 se despliega en Estados Unidos, Europa y Australia, y ofrece hasta 1,7 veces más tokens por vatio para las capacidades de IA integradas en Microsoft Teams, Copilot y las experiencias de Cowork, en comparación con las principales infraestructuras basadas en GPU, según los datos facilitados por Microsoft.
Los resultados obtenidos con Maia 200 también han contribuido al diseño de Maia 300, concebido para cargas de trabajo que requieren razonamiento con contextos extensos, interacciones conversacionales sensibles a la latencia y tareas agénticas de varios pasos.
Ambas generaciones están orientadas a una amplia variedad de servicios y aplicaciones:
GitHub Copilot: ejecución más eficiente de tareas de programación y flujos de trabajo agénticos de varios pasos.
Microsoft Foundry: ejecución de modelos a escala de nube, con soporte para diferentes arquitecturas y entornos de implementación.
Equipo de MAI: inferencia y generación de datos para el desarrollo de modelos propios.
Dragon Copilot: interacciones de baja latencia que contribuyen a ampliar los flujos de trabajo clínicos y reducir la carga administrativa de los profesionales sanitarios.
La combinación de ambas generaciones permite adaptar la infraestructura a diferentes perfiles de demanda, desde las respuestas conversacionales que requieren tiempos de reacción reducidos hasta los procesos de razonamiento más intensivos en memoria y computación.
Maia 300: más rendimiento de IA por cada megavatio
Maia 300, tercera generación del programa Azure Maia, se ha diseñado con una arquitectura centrada en la inferencia y optimizada para modelos que requieren grandes cantidades de memoria, contextos extensos y una elevada carga de decodificación.
Microsoft estima que el sistema ofrecerá un 40 % más de tokens por megavatio que los principales sistemas basados en GPU. En una configuración completa de 96 aceleradores, la compañía también señala un rendimiento de tokens a escala de rack de hasta siete veces el de Maia 200.
Estas cifras reflejan el enfoque de diseño de Maia 300: mejorar el aprovechamiento de los recursos disponibles mediante la coordinación de la computación, la memoria y las redes, en lugar de centrarse exclusivamente en aumentar la potencia de cálculo.
Las claves técnicas de Azure Maia 300
1. Menor movimiento de datos y mayor aprovechamiento de la computación
En los sistemas de inferencia de gran tamaño, el movimiento de datos constituye un factor determinante del rendimiento. La arquitectura de flujo de datos definida por software de Maia 300, combinada con la optimización de kernels asistida por IA, busca mantener los datos cerca de los recursos que los procesan y reducir los desplazamientos innecesarios.
Este enfoque permite mejorar el uso conjunto de la computación, la memoria y la red. La eficiencia depende así no solo de la potencia de cálculo, sino también de la capacidad del sistema para alimentar los aceleradores con los datos necesarios y evitar cuellos de botella.
2. Más ancho de banda de memoria por vatio
Maia 300 integra ocho pilas de memoria HBM4, con un ancho de banda máximo de 18 TB/s y una potencia de diseño térmico (TDP) de 950 vatios, según las especificaciones de Microsoft.
Esta capacidad está orientada a ejecutar modelos de gran tamaño y cargas de trabajo con contextos extensos, que requieren un acceso intensivo a la memoria. Además, los kernels especializados aprovechan la memoria SRAM integrada en el chip como espacio temporal gestionado por software, lo que contribuye a reducir la presión sobre la memoria HBM.
La combinación de capacidad y ancho de banda resulta especialmente relevante para las tareas de inferencia en las que el acceso a los datos condiciona el rendimiento y el consumo energético.
3. Arquitectura de chiplets para mejorar la eficiencia
La arquitectura multichiplet de Maia 300 separa las funciones de computación, control de memoria y entrada/salida. Esta distribución busca mejorar la eficiencia, facilitar la escalabilidad y optimizar la estructura de costes del sistema.
Los chiplets de computación se fabrican con el proceso N2P de TSMC, seleccionado para maximizar el rendimiento por vatio. La separación funcional permite adaptar los distintos componentes a sus necesidades específicas y organizar la arquitectura para responder a las exigencias de las cargas de trabajo de IA.
4. Contextos más amplios y modelos más eficientes
Maia 300 incorpora soporte para formatos avanzados de baja precisión, incluido MXFP4 mejorado. Estas técnicas permiten reducir las necesidades de memoria y ancho de banda tanto para la computación como para el almacenamiento de la caché KV, utilizada para conservar información relevante durante la generación de respuestas.
La reducción de estos requisitos puede facilitar ventanas de contexto más amplias y un mayor rendimiento dentro de un mismo límite energético. Esto resulta importante para aplicaciones que necesitan procesar grandes cantidades de información, mantener conversaciones extensas o ejecutar secuencias de razonamiento complejas.
5. Conectividad integrada para escalar en el centro de datos
Maia 300 trata la red como una parte integrada de su arquitectura de flujo de datos definida por software. Las operaciones abarcan los recursos de computación, memoria y comunicación como un sistema coordinado, con el propósito de reducir las ineficiencias derivadas de las distintas capas de procesamiento.
Las interconexiones de gran ancho de banda entre aceleradores están optimizadas para el paralelismo de tensores. Además, un sistema de transporte de IA personalizado proporciona comunicaciones de alto rendimiento y fiabilidad entre aceleradores y racks.
Esta solución aprovecha una infraestructura de red basada en Ethernet y permite una topología unificada, preparada para escalar desde un rack individual hasta despliegues que abarcan centros de datos completos.
6. Mayor densidad de procesamiento por rack
Los sistemas de Maia 300 reúnen 96 aceleradores por rack, con un consumo de hasta 167 kW. La configuración proporciona 27,6 TB de capacidad HBM y un ancho de banda agregado de memoria de 1,7 PB/s dentro de un dominio de escalado de alta velocidad.
Esta densidad permite atender más interacciones simultáneas y procesar cargas de trabajo de mayor tamaño dentro de una misma infraestructura física. Para los operadores de centros de datos, el objetivo es mejorar el aprovechamiento de las instalaciones y la rentabilidad de la capacidad destinada a servicios de IA.
La eficiencia energética como factor estratégico de la infraestructura de IA
La expansión de los sistemas de inteligencia artificial plantea exigencias crecientes en materia de energía, memoria, conectividad y capacidad de procesamiento. A medida que las aplicaciones incorporan agentes capaces de razonar, ejecutar acciones y coordinar tareas, la infraestructura debe responder a cargas de trabajo más complejas sin comprometer la eficiencia ni la escalabilidad.
Maia 300 aborda este reto mediante una arquitectura que coordina los distintos recursos del sistema y busca obtener más rendimiento útil de cada unidad de energía consumida. La optimización del movimiento de datos, el ancho de banda de memoria, la conectividad y la densidad de aceleradores son elementos complementarios de esta estrategia.
La eficiencia por megavatio también tiene implicaciones económicas: una mayor capacidad de inferencia dentro de un presupuesto energético determinado puede facilitar la prestación de más servicios y atender una demanda creciente sin que el consumo aumente en la misma proporción.
Microsoft prevé que los despliegues de Maia 300 en producción comiencen en 2027. Los detalles técnicos de la arquitectura están disponibles en el análisis técnico de Azure Maia 300.
Azure Maia como componente de la transformación de Microsoft con IA
La estrategia de Microsoft no se basa en un único modelo ni en una sola arquitectura de chip. La compañía plantea una plataforma heterogénea que combina distintas tecnologías de hardware, modelos y sistemas, con el objetivo de ofrecer soluciones escalables, accesibles y adaptadas a diferentes necesidades.
Esta aproximación permite optimizar la infraestructura de extremo a extremo, desde los centros de datos y los aceleradores hasta los agentes y las aplicaciones. Azure Maia desempeña un papel relevante en esa arquitectura al proporcionar una plataforma propia para ejecutar cargas de trabajo de inferencia y adaptar el rendimiento a las exigencias de los servicios de Microsoft.
La combinación de Maia 200 y Maia 300 refuerza esta estrategia mediante sistemas diseñados para atender perfiles de demanda diversos, desde las interacciones sensibles a la latencia hasta las tareas agénticas y los modelos que necesitan grandes cantidades de memoria.
La infraestructura de IA se configura así como una base tecnológica para ampliar las capacidades de los servicios digitales, mejorar la eficiencia operativa y ofrecer a las organizaciones más opciones para desplegar soluciones de inteligencia artificial a escala.